Metriken-Export
Der OPC Router erfasst kontinuierlich Laufzeit-Metriken und kann diese an externe Monitoring-Systeme wie Grafana, Prometheus oder InfluxDB exportieren. Eine Teilmenge der Metriken ist direkt im Service-Dashboard einsehbar.
Der Export von Metriken per OTLP oder InfluxDB erfordert eine aktive Enterprise+-Lizenz. Weitere Informationen zur Lizenzzuordnung und zu anderen Enterprise+-Funktionen finden Sie unter Lizenzstufen. Einige systemweite Metriken (CPU, Arbeitsspeicher, Laufwerke) werden unabhängig davon intern aufgezeichnet und im Service-Dashboard angezeigt.
Konfiguration
Die Einstellungen finden Sie im Menü unter Optionen → Monitoring und Diagnose, dort im Abschnitt Telemetrie- und Log-Export-Einstellungen. Dieselbe Seite bündelt auch die Logausgaben und die interne Metrik-Aufzeichnung; für den Export sind die Karten Zentrale Metriksammlung über OTLP und Zentrale Metriksammlung über InfluxDB zuständig. Die Karte Zentrale Log-Erfassung über OTLP exportiert Logs statt Metriken und ist hier nicht beschrieben.
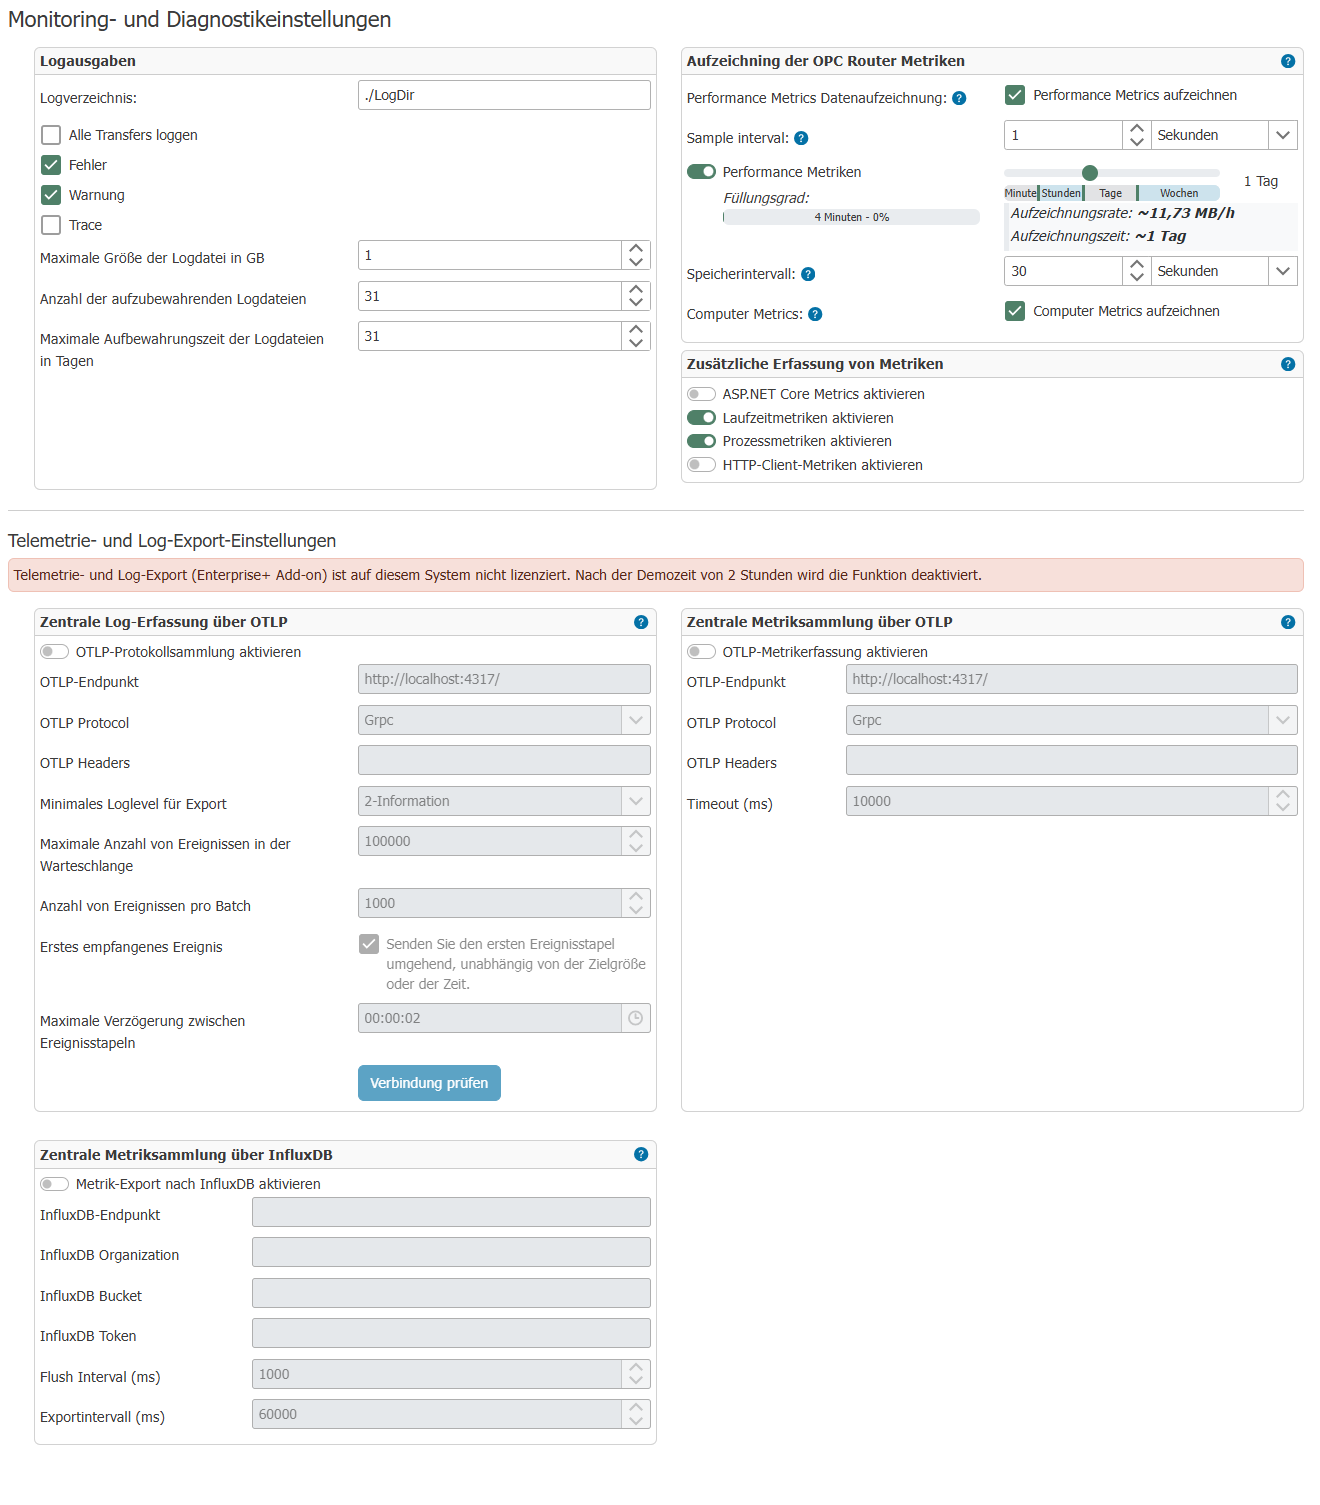
OTLP
| Eigenschaft | Beschreibung |
|---|---|
| OTLP-Metrikerfassung aktivieren | Aktiviert den OTLP-Export |
| OTLP-Endpunkt | Zieladresse des OTLP-Collectors, z. B. http://localhost:4317 |
| OTLP Protocol | Übertragungsprotokoll: gRPC (Standard) oder HTTP/Protobuf |
| OTLP Headers | Optionale HTTP-Header, z. B. für Authentifizierung (Authorization: Bearer ...) |
| Timeout (ms) | Zeitlimit für die Übertragung an den Collector (Standard: 10.000 ms) |
InfluxDB
| Eigenschaft | Beschreibung |
|---|---|
| Metrik-Export nach InfluxDB aktivieren | Aktiviert den InfluxDB-Export |
| InfluxDB-Endpunkt | URL der InfluxDB-Instanz, z. B. http://localhost:8086 |
| InfluxDB Organization | InfluxDB-Organisation |
| InfluxDB Bucket | Ziel-Bucket |
| InfluxDB Token | API-Token für die Authentifizierung |
| Flush Interval (ms) | Wie häufig gesammelte Metriken geschrieben werden (Standard: 1.000 ms) |
| Exportintervall (ms) | Messintervall (Standard: 60.000 ms) |
Der InfluxDB-Token und die OTLP-Header werden direkt in den Feldern hinterlegt; sie lassen sich nicht aus der zentralen Secrets-Ablage auswählen. Vergeben Sie deshalb einen Token, der nur die Schreibrechte auf das genutzte Bucket besitzt.
System-Instrumentierung
Die Schalter stehen auf derselben Seite in der Karte Zusätzliche Erfassung von Metriken.
| Eigenschaft | Beschreibung | Standard |
|---|---|---|
| Laufzeitmetriken aktivieren | Laufzeit-Metriken der .NET-Runtime (GC, Thread-Pool, ...) | Aktiv |
| Prozessmetriken aktivieren | Prozess-Metriken (CPU-Zeit, Speicher) | Aktiv |
| ASP.NET Core Metrics aktivieren | HTTP-Server-Metriken | Inaktiv |
| HTTP-Client-Metriken aktivieren | Metriken ausgehender HTTP-Anfragen | Inaktiv |
So lesen Sie die Metriken
Für die Auswertung ist nicht nur der Metrikname wichtig, sondern auch der Metriktyp:
| Typ | Bedeutung | Typische Nutzung |
|---|---|---|
| Gauge | Momentaufnahme eines aktuellen Zustands | Aktuelle Auslastung, Queue-Größe, Status |
| Counter | Monoton steigender Zähler | Fehleranzahl, erfolgreiche Ausführungen, Verbindungsversuche |
| Histogram | Verteilung von Messwerten | Latenzen, Bearbeitungszeiten, Nachrichtengrößen |
Viele Metriken werden zusätzlich mit Attributen exportiert, zum Beispiel dem Flow-Namen. Dadurch lässt sich dieselbe Metrik pro Flow, Plug-in oder Zielsystem getrennt auswerten.
Einzelne Metriken sind oft erst in Kombination aussagekräftig. Eine steigende Queue-Tiefe ist zum Beispiel erst dann problematisch, wenn gleichzeitig die Worker-Auslastung hoch bleibt oder die Bearbeitungszeiten ansteigen.
Kardinalität: Zeitreihen je Metrik
Jede Attributkombination einer Metrik – in Monitoring-Systemen auch Tag-Kombination genannt – bildet eine eigene Zeitreihe. Für diese Zeitreihen wird Speicher reserviert, sobald die Metrikerfassung läuft – auch ohne aktiven Export, da das Service-Dashboard dieselbe Erfassung nutzt.
Standardmäßig werden zu jeder Metrik höchstens 128 Zeitreihen einzeln geführt. Alle weiteren Attributkombinationen fasst die Erfassung in einem gemeinsamen Overflow-Punkt zusammen. Deren Werte sind dann nicht mehr nach Attributen auswertbar.
Erzeugt eine Anlage – zum Beispiel durch sehr viele Flows, Trigger oder Plug-in-Instanzen – auf einer Metrik mehr als 128 Attributkombinationen, heben Sie das Limit über die Umgebungsvariable OR_METRICS_CARDINALITY_LIMIT an. Ein höheres Limit erhöht den Speicherbedarf je Dienstprozess. Die Änderung wirkt nach einem Neustart der Dienste. Siehe Umgebungsvariablen für Metriken.
Wertemapping für Statusmetriken
Einige Statusmetriken werden als numerische Werte exportiert. Für Dashboards und Alarme sollte deshalb eine feste Wertetabelle verwendet werden.
inray.service.escalation_level
Beschreibt den globalen Gesundheitszustand des OPC Routers.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
-2 | Undefined | Zustand ist noch nicht bestimmbar |
-1 | Initializing | Dienst initialisiert noch interne Komponenten |
0 | EscalationLevel0 | Normalbetrieb |
1 | EscalationLevel1 | Gute, stark wiederholte Transferwerte werden teilweise verworfen |
2 | EscalationLevel2 | Gute Transferwerte werden verworfen |
3 | EscalationLevel3 | Transferwerte werden vollständig verworfen |
4 | EscalationLevel4 | Nachrichten normaler Priorität werden verworfen |
inray.connections.state
Beschreibt den aktuellen Zustand eines Flows.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
-1 | Null | Noch kein gültiger Flow-Zustand vorhanden |
0 | StartUp | Flow startet |
1 | Validate | Flow wird geprüft |
2 | Ready | Flow ist betriebsbereit |
3 | TriggerCheckError | Fehler bei der Trigger-Prüfung |
4 | TriggerStatusError | Fehler im Trigger-Status |
5 | TriggerConfigError | Fehler in der Trigger-Konfiguration |
6 | PlugInError | Fehler in einem beteiligten Plug-in |
7 | NoLicense | Lizenz fehlt oder ist ungültig |
8 | ShutDown | Flow wird beendet oder ist heruntergefahren |
9 | StandBy | Flow ist inaktiv, aber vorhanden |
inray.connections.execution.state
Beschreibt das Ergebnis des letzten ausgeführten Flows.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
0 | None | Noch keine Ausführung oder kein Ergebnis vorhanden |
1 | Ok | Letzte Ausführung erfolgreich |
2 | Aborted | Ausführung wurde abgebrochen |
3 | Error | Ausführung endete mit Fehler |
4 | Pending | Ausführung steht noch aus |
5 | Forwarded | Ausführung wurde weitergeleitet |
6 | Discarded | Ausführung wurde verworfen |
inray.connections.trigger.state und inray.connections.trigger.async.status
Beschreibt den Zustand des Triggers eines Flows.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
0 | None | Noch kein gültiger Triggerstatus vorhanden |
1 | Ok | Trigger arbeitet ordnungsgemäß |
2 | StatusError | Trigger meldet einen Statusfehler |
3 | CheckError | Trigger-Prüfung fehlgeschlagen |
4 | ConfigError | Trigger ist fehlerhaft konfiguriert |
inray.plugins.instance.status
Beschreibt den Zustand einer Plug-in-Instanz.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
0 | Uninitialized | Plug-in wurde noch nicht initialisiert |
1 | Initializing | Plug-in startet oder initialisiert Ressourcen |
2 | Ok | Plug-in arbeitet ordnungsgemäß |
3 | Warning | Plug-in arbeitet, meldet aber Warnungen |
4 | Error | Plug-in ist fehlerhaft |
5 | Stopped | Plug-in ist gestoppt |
6 | NoLicense | Plug-in kann wegen fehlender Lizenz nicht ausgeführt werden |
inray.opcua.connection_manager.state
Beschreibt den Verbindungszustand des OPC-UA-Connection-Managers.
| Wert | Bedeutung | Praktische Interpretation |
|---|---|---|
0 | Disconnected | Keine aktive Verbindung zum OPC-UA-Server |
1 | Connected | Verbindung steht |
2 | InvalidConfig | Verbindung kann wegen ungültiger Konfiguration nicht aufgebaut werden |
Verfügbare Metriken
Alle Metriken tragen das Präfix inray. und können mit Attributen (Dimensionen) wie dem Flow-Namen oder dem Plug-in-Typ angereichert sein.
Plug-in-spezifische Metriken werden nur exportiert, wenn das jeweilige Plug-in lizenziert und aktiv ist. Welche Metriken tatsächlich geliefert werden, hängt von der Konfiguration und dem Laufzeitzustand des OPC Routers ab.
Dienst & System
Allgemeine Zustandsmetriken des OPC-Router-Dienstes und des Host-Systems.
Hilfreich für:
- Überwachung des Gesamtzustands des Dienstes
- Erkennen von CPU-, Speicher- oder Speicherplatzengpässen
- Alarmierung bei kritischen Betriebszuständen
Darunter u. a. folgende Metriken:
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.service.escalation_level | Gauge | - | Globaler Gesundheitszustand des OPC Routers; die numerischen Werte sollten über die obige Wertetabelle aufgelöst werden |
inray.service.used_memory_bytes | Gauge | Bytes | Speicherverbrauch des Prozesses |
inray.system.processor_usage | Gauge | % | CPU-Auslastung des Host-Systems |
inray.system.memory_usage | Gauge | % | Speicherauslastung des Host-Systems |
inray.system.free_memory_bytes | Gauge | Bytes | Verfügbarer Arbeitsspeicher |
inray.drives.{Laufwerk}.free_bytes | Gauge | Bytes | Freier Speicherplatz je Laufwerk |
inray.drives.{Laufwerk}.total_bytes | Gauge | Bytes | Gesamtgröße je Laufwerk |
Transfer-Manager
Metriken zum internen Verarbeitungs-Scheduler des OPC Routers. Diese Werte bilden die Grundlage des Service-Dashboards.
Hilfreich für:
- Erkennen von Rückstau im Verarbeitungspfad
- Bewertung, ob genügend Worker-Threads verfügbar sind
- Analyse, ob steigende Latenzen durch Last oder durch einzelne langsame Transfers verursacht werden
Die Anzeige Systemlast nachrechnen
Die Anzeige „Systemlast“ im Dienststatus basiert direkt auf diesen beiden Metriken:
- Regular:
inray.transfer_manager.default_prio_average_workload - High Prio:
inray.transfer_manager.high_prio_average_workload
Die Berechnung erfolgt in drei Schritten:
- Für jeden Worker-Thread wird pro Messintervall ein Auslastungs-Sample gebildet:
load_sample = activeMs / (activeMs + idleMs)
Dabei ist activeMs die Zeit, in der der Thread tatsächlich Transfers bearbeitet, und idleMs die Zeit, in der der Thread wartet.
- Der OPC Router speichert pro Worker-Thread den Durchschnitt der letzten bis zu 10 Samples:
load_thread = (load_sample_1 + load_sample_2 + ... + load_sample_n) / n
mit n <= 10.
- Das Dashboard liest für den gewählten Zeitraum alle gespeicherten Werte der jeweiligen Metrik und bildet daraus erneut den arithmetischen Mittelwert:
load_dashboard = (load_thread_1 + load_thread_2 + ... + load_thread_m) / m
Die Anzeige der Gauge erfolgt anschließend als Prozentwert:
Anzeige in % = load_dashboard * 100
Beispiel:
- Ein Dashboard-Wert von
0.37entspricht einer angezeigten Systemlast von37 %. - Ein Dashboard-Wert von
0.85entspricht85 %und deutet auf eine hohe dauerhafte Auslastung hin. - Wenn für den gewählten Zeitraum keine Werte vorliegen, zeigt die Gauge N/A.
Wichtig für die Interpretation:
- Die Gauge zeigt keine CPU-Auslastung des Hosts, sondern die zeitliche Auslastung der Transfer-Worker.
- Die Gauge ist ein gemittelter Verlauf, kein Momentanwert eines einzelnen Threads.
- Für Regular werden die Werte der normalen und niedrigen Priorität verwendet, für High Prio die Werte der hochpriorisierten Worker.
Darunter u. a. folgende Metriken:
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.transfer_manager.queue_depth | Gauge | Items | Anzahl aktuell wartender Transfer-Ausführungen über alle Prioritäten; ein dauerhaft steigender Wert weist auf Rückstau hin |
inray.transfer_manager.queue_depth.high_priority | Gauge | Items | Aktuell wartende hochpriorisierte Ausführungen; sollte bevorzugt niedrig bleiben |
inray.transfer_manager.queue_depth.normal_priority | Gauge | Items | Aktuell wartende normal priorisierte Ausführungen |
inray.transfer_manager.queue_depth.low_priority | Gauge | Items | Aktuell wartende niedrig priorisierte Ausführungen |
inray.transfer_manager.busy_worker_threads | Gauge | Threads | Beschäftigte Worker-Threads |
inray.transfer_manager.ready_worker_threads | Gauge | Threads | Bereite Worker-Threads |
inray.transfer_manager.worker_thread_utilization | Gauge | % | Gesamtauslastung aller Worker; dauerhaft hohe Werte zusammen mit wachsender Queue deuten auf Kapazitätsgrenzen hin |
inray.transfer_manager.utilization.high_priority | Gauge | % | Anteil der Verarbeitungszeit für hochpriorisierte Transfers |
inray.transfer_manager.utilization.normal_priority | Gauge | % | Anteil der Verarbeitungszeit für normal priorisierte Transfers |
inray.transfer_manager.utilization.low_priority | Gauge | % | Anteil der Verarbeitungszeit für niedrig priorisierte Transfers |
inray.transfer_manager.average_triggers_per_second | Gauge | Items/s | Mittlere Eingangsrate in den Transfer-Manager |
inray.transfer_manager.average_processing_time_per_item | Gauge | ms | Mittlere Bearbeitungszeit pro verarbeitetem Item |
inray.transfer_manager.trigger_transfer_delay | Histogram | ms | Zeit zwischen Trigger-Ereignis und tatsächlicher Abarbeitung; wichtig für Latenzanalysen |
inray.transfer_manager.tags_executed | Histogram | Tags | Anzahl verarbeiteter Tags pro Transfer; hilft beim Einordnen, warum ein Transfer länger dauert |
inray.transfer_manager.default_prio_average_workload | Gauge | - | Backpressure für normale und niedrige Priorität; je höher der Wert, desto mehr Arbeit konnte nicht direkt übernommen werden |
inray.transfer_manager.high_prio_average_workload | Gauge | - | Backpressure für hohe Priorität |
Typische Lesart:
queue_depthsteigt,worker_thread_utilizationbleibt hoch: Der Router verarbeitet kontinuierlich am Limit.average_processing_time_per_itemsteigt,tags_executedsteigt ebenfalls: Die Transfers werden inhaltlich schwerer, nicht nur zahlreicher.high_prio_average_workloadsteigt, obwohl normale Queue niedrig ist: Hochpriorisierte Flows benötigen gezielte Analyse.
Flows
Metriken pro konfiguriertem Flow, dimensioniert mit dem Flow-Namen.
Hilfreich für:
- Erkennen fehlerhafter oder langsamer Einzel-Flows
- Vergleich einzelner Flows in Grafana oder InfluxDB
- Alarmierung bei Statuswechseln oder steigender Fehlerquote
Darunter u. a. folgende Metriken:
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.connections.execution.count | Counter | - | Gesamtanzahl Ausführungen |
inray.connections.execution.success.count | Counter | - | Erfolgreiche Ausführungen |
inray.connections.execution.error.count | Counter | - | Fehlerhafte Ausführungen |
inray.connections.execution.duration | Histogram | ms | Ausführungsdauer |
inray.connections.execution.type.duration | Histogram | µs | Ausführungsdauer je Ergebnisart, zum Beispiel Ok, Error oder Aborted |
inray.connections.state | Gauge | - | Aktueller Flow-Status; die Zahlenwerte sollten über die obige Wertetabelle aufgelöst werden |
inray.connections.execution.state | Gauge | - | Ergebnis der letzten Ausführung; hilfreich für Single-Stat-Panels oder Statusampeln |
inray.connections.total.ok.count | Gauge | - | Flows im OK-Zustand |
inray.connections.total.error.count | Gauge | - | Flows im Fehlerzustand |
inray.connections.total.deactivated.count | Gauge | - | Deaktivierte Flows |
Typische Lesart:
execution.error.countsteigt, währendexecution.countebenfalls steigt: Der Flow arbeitet, produziert aber Fehler.execution.durationsteigt ohne erhöhte Triggerlast: Ursache liegt eher in der Verarbeitung oder im Zielsystem als im Trigger.connections.state = 7: Der Flow ist nicht technisch gestört, sondern lizenzbedingt blockiert.
Trigger
Metriken für asynchrone Trigger, dimensioniert mit dem Flow-Namen.
Hilfreich für:
- Analyse überlaufender oder zu kleiner Trigger-Queues
- Bewertung, ob Trigger schneller erzeugt als verarbeitet werden
- Unterscheidung zwischen Konfigurationsfehlern und Laufzeitengpässen
Darunter u. a. folgende Metriken:
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.connections.trigger.async.status | Gauge | - | Zustand des asynchronen Triggers; die Zahlenwerte sollten über die obige Wertetabelle aufgelöst werden |
inray.connections.trigger.async.queued_events | Gauge | - | Aktuell aufgelaufene Trigger-Ereignisse, die noch nicht verarbeitet wurden |
inray.connections.trigger.async.queue_limit | Gauge | - | Konfiguriertes Maximum der Trigger-Warteschlange |
inray.connections.trigger.async.enqueue.count | Counter | - | Gesamt eingereihte Events |
inray.connections.trigger.async.dequeue.count | Counter | - | Gesamt verarbeitete Events |
inray.connections.trigger.async.dequeue.dropped_timeout | Counter | - | Verworfene Events (Timeout) |
inray.connections.trigger.async.queued_per_second_avg | Gauge | Events/s | Mittlere Eingangsrate |
inray.connections.trigger.async.dequeued_per_second_avg | Gauge | Events/s | Mittlere Abarbeitungsrate |
inray.connections.trigger.async.dropped_per_second_avg | Gauge | Events/s | Mittlere Verwerfungsrate |
Typische Lesart:
queued_eventsnähert sichqueue_limit: Die Queue ist zu klein oder die Abarbeitung zu langsam.queued_per_second_avgliegt dauerhaft überdequeued_per_second_avg: Rückstau baut sich auf.dequeue.dropped_timeoutsteigt: Der Flow kann Trigger-Ereignisse nicht rechtzeitig abarbeiten.
OPC UA
Metriken der OPC-UA-Verbindungsverwaltung, dimensioniert mit der Server-Adresse.
Hilfreich für:
- Überwachung der Stabilität von OPC-UA-Verbindungen
- Erkennen von Konfigurationsproblemen oder instabilen Sessions
- Bewertung des Lese- und Abo-Verhaltens
Darunter u. a. folgende Metriken:
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.opcua.connection_manager.state | Gauge | - | Verbindungsstatus des OPC-UA-Managers; die Zahlenwerte sollten über die obige Wertetabelle aufgelöst werden |
inray.opcua.connection_manager.connection_established_successful.count | Counter | - | Erfolgreiche Verbindungsaufbauten |
inray.opcua.connection_manager.connection_established_failed.count | Counter | - | Fehlgeschlagene Verbindungsaufbauten |
inray.opcua.connection_manager.keep_alive_failed.count | Counter | - | Keep-Alive-Fehler |
inray.opcua.connection_manager.watchdog_cycle_duration | Histogram | ms | Dauer des Watchdog-Zyklus |
inray.opcua.group.item_count | Gauge | - | Anzahl abonnierter Items je Gruppe |
Plug-ins
Metriken für das Plug-in-System sowie plug-in-spezifische Metriken einzelner Plug-in-Typen. Diese Metriken stehen nur zur Verfügung, wenn das jeweilige Plug-in aktiv und lizenziert ist.
Allgemeine Plug-in-Metriken
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.plugins.instance.count | Gauge | - | Anzahl aktiver Plug-in-Instanzen |
inray.plugins.instance.status | Gauge | - | Zustand einer Plug-in-Instanz; die Zahlenwerte sollten über die obige Wertetabelle aufgelöst werden |
inray.plugins.execution.count | Counter | - | Gesamtanzahl Plug-in-Ausführungen |
inray.plugins.execution.time.histogram | Histogram | ms | Ausführungsdauer je Plug-in-Instanz |
inray.plugins.total.ok.count | Gauge | - | Plug-ins im OK-Zustand |
inray.plugins.total.error.count | Gauge | - | Plug-ins im Fehlerzustand |
inray.plugins.total.warning.count | Gauge | - | Plug-ins mit Warnungen |
MQTT-Plug-in
| Metrik | Typ | Einheit | Beschreibung |
|---|---|---|---|
inray.mqtt.connections.active | Gauge | - | Aktive MQTT-Verbindungen |
inray.mqtt.connect.attempt | Counter | - | Verbindungsversuche |
inray.mqtt.connect.ok | Counter | - | Erfolgreiche Verbindungen |
inray.mqtt.connect.fail | Counter | - | Fehlgeschlagene Verbindungen |
inray.mqtt.publish.ok | Counter | - | Erfolgreich veröffentlichte Nachrichten |
inray.mqtt.publish.fail | Counter | - | Fehlgeschlagene Veröffentlichungen |
inray.mqtt.publish.latency.ms | Histogram | ms | Publish-Latenz |
inray.mqtt.payload.bytes | Histogram | Bytes | Nachrichtengröße |
.NET Runtime & Prozess
Wenn die System-Instrumentierung aktiv ist, exportiert der OPC Router zusätzlich Standard-Metriken der .NET-Laufzeitumgebung und des Betriebssystemprozesses (standardmäßig aktiv). Diese umfassen u. a. Garbage-Collector-Statistiken, Thread-Pool-Auslastung und Prozess-CPU-Zeit.